블록체인 데이터를 모으려는 자는 3가지 질문에 답을 해야한다!
그대, 20TB 하드는 있는가?
... 농담이고, 너무 무겁게 글을 시작하고 싶진 않아서 좀 밈을 넣어봤다. 그래도 뜬금없이 20TB 하드는 괜히 한 이야기는 아니다. 실제로 용량이 많으면 많을수록 ETL을 짜기 정말 좋을 것이다. 그럼 시작한다!
1. ETL이 뭔가요
Extract, Transfrom, Load의 줄임말이다. 결론적으로는 실제 데이터 원천을 어떻게 만들고, 가공하고, DB에 보기 좋게 적재할 것인가를 묻는 것이다. 나도 거창하게 ETL을 다 알고 있다고 할 수는 없고... 그것보다는 내가 총 4번정도, Tron blockchain을 데이터마이닝을 시도 해봤는데, 뭘 느꼈고 어떻게 발전을 해 나갔는지 등을 정리를 좀 해두려고 한다.
우선 대략적으로 내가 이런 데이터를 다루면서 느낀 점이 좀 있다.
1. 고용량 데이터 storage를 확보할 것(대여는 그렇게 추천하진 않음).
2. backfill과 아닌 부분을 명확히 할 것.
3. tx데이터의 주소는 치환하여 저장해 둘 것.
이다.
2. 느낀 점에 관한 설명
(1) 고용량 데이터 storage를 확보할 것
이건 생각보다 정말 중요하고, 사실 이것 때문에 그냥 학부생이 턱하고 이런 분야에 도전하기 쉽지 않다는 생각도 했다. 하지만 엔지니어로써 제일 비용과 관련된 부분을 빼놓으면 섭하기 때문에 이야기는 해야한다. 우선 트론 블럭체인을 가져오는 방법은 생각보다 간단하다. 이 체인에는 풀 스냅샷이라는게 있어서, 기본적으로 이걸 가져오면 굳이 fullnode 같은 것을 운용하지 않더라고 데이터의 전부분을 가져와서 분석할 수 있다. 이후에는 그냥 trongrid같은 곳에서 block이란 recipt만 꼬박꼬박 가져와도 충분히 따라 잡을 수 있다.
근데 문제는 뭐냐면 그냥 fullnode 스냅샷 자체만으로도 3.4TB는 먹는다는 거다. 그냥 다운로드만 받아도 이 모양이고, 실제로 압축해제까지 진행하면 4.1TB 정도 한다. 이거 가지고 뭐 해보려고하면 정말 고용량 저장공간이 정말 절실해진다. 이런건 S3같은데 맘 편하게 담아둘수도 없는 크기이고, 사실은 그냥 맘편하게 고용량 하드디스크 내지는 자기테이프(LTO)라도 있는 편이 좋다. volume을 aws같은데 잡아서 잠깐만 처리 하겠다는 생각은 안하는게 좋다. 해봤으니까 이야기하는 거다...
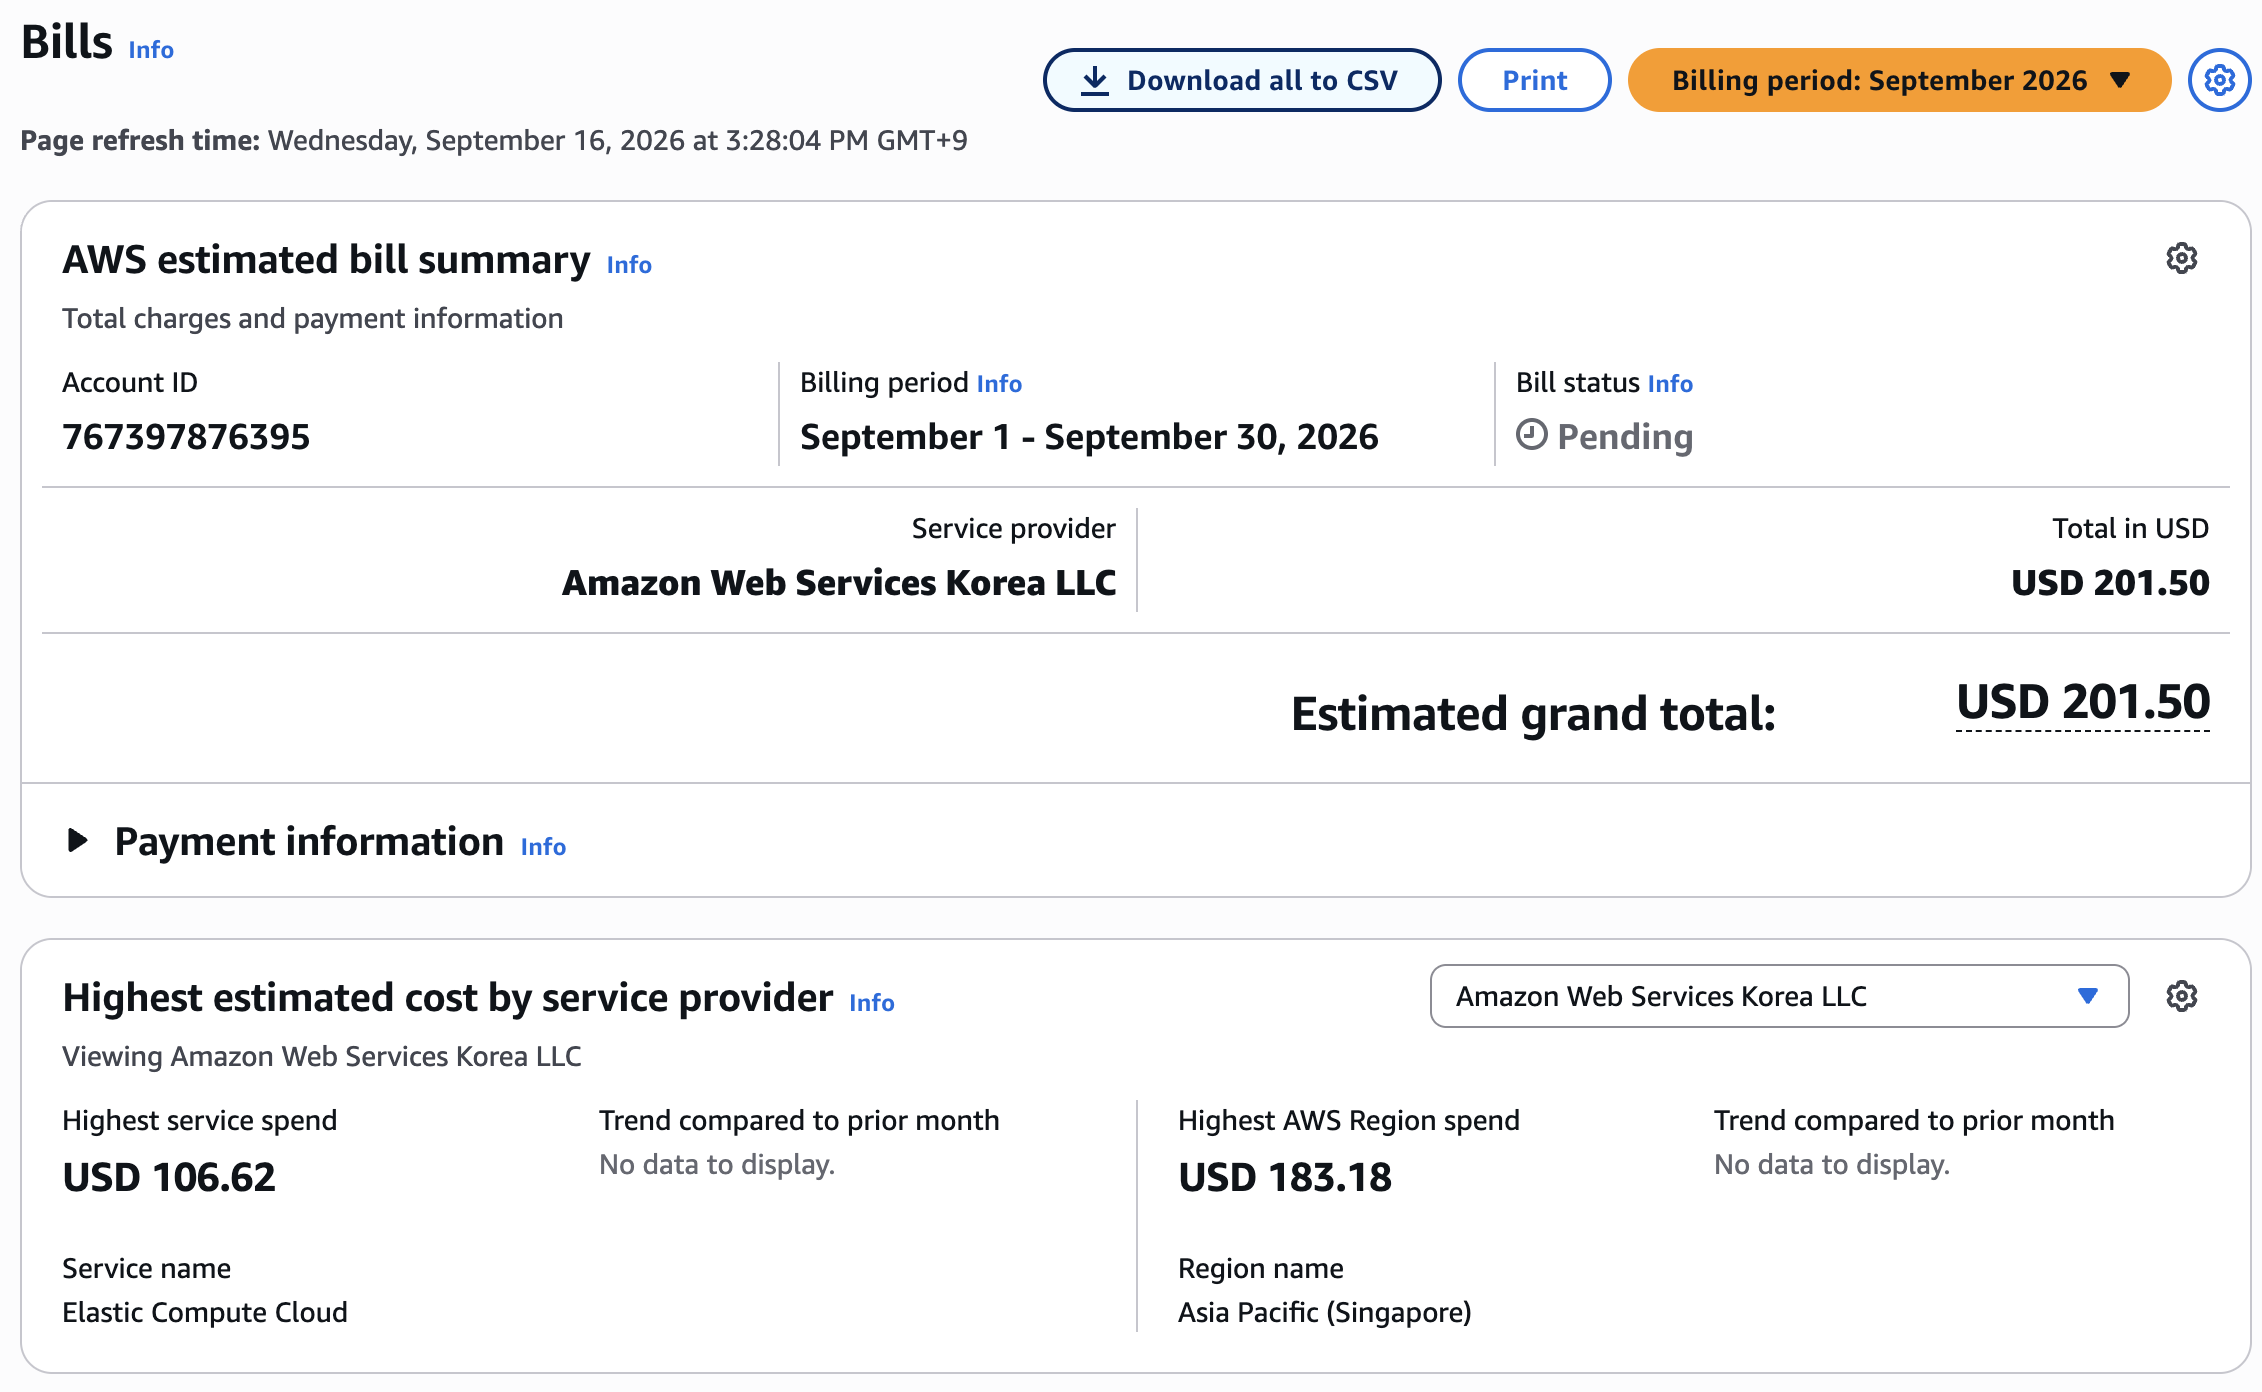
** 물론 내가 잘못된 판단을 몇개 해서 그렇긴 한데, 이런 잠깐 사이에 일어나는 일에 숙련되기는 쉽지 않다... 그냥 "할 수 있다 나라면" 하지 말고 하드 사자
그렇다고 SSD일 필요는 없다. 어짜피 압축이 Gzip이라 순차처리밖에 안된다. 내부를 풀면 leveldb로 되어있긴 하다만, 순차처리 가능하게 tx를 binary형태로 만들어서 나중에 leveldb를 뒤질일이 없게 만들어 버리면 그만이다. (어짜피 백업이다 그말이에요) 물론 그때 동안은 2TB ssd정도는 있으면 좋다. 무엇보다도, 하드를 구매한다면 적어도 그 하드 + 데이터는 계속 곁에 남는 반면에 저 위에 있는건 아마존에 줘버리면 그냥 사라진다. 기회비용상 그냥 고용량 데이터스토어가 하나 있는게 좋다.
개인이 LTO리더기 최신세대는 못구할거고... LTO5~6정도 되는거를 좀 사다가 써보거나, 맘편하게 하드 하나 넣는게 일단 저 망할 200달러 내는것 보단 나을 것 같다...(환율을 1300원이라고 해도 26만원이다...)
(2)backfill과 아닌 부분을 명확히 할 것.
데이터 파이프라인을 설계할 때 fullnode snapshot -> 이후의 catch-up 구조로 이루어진다는 것을 생각을 하라는 것이다. 이전의 1, 2번째 파이프라인은 이러한 full snapshot의 존재를 몰랐는데, 그것 때문에 trongrid같은 데에서 그냥 진짜 찔끔찔끔 가져올 수 밖에 없었고, 데이터를 그냥 모으는데도 시간이 꽤나 걸렸다. 하루마다 API call도 10만건이 끝이고, RPS도 5정도가 한계이기 때문에 이런쪽으로도 설계를 계속해야 한다는 것이 굉장히 짜증난다.
스타트라인을 850만 블럭까지 해놓고 가면 이미 분석할 데이터는 충분하고 차고 넘친다. 이 상태에서 앞으로 가져올 일부만 생각하면 되서 파이프라인이 훨씬 간단해지니까... 사실 하고 싶은 말은 full snapshot을 이용하라는 것이다.
(3) tx데이터의 주소는 치환하여 저장해 둘 것.
이건 엄밀히 말하자면 비용이긴 한데... 그래도 해둘 만한 트릭이다. tron의 account 주소는 중요한 부분만 따지면 20byte짜리 HEX이다. (맨 앞에 'T'를 붙이긴 하는데 이건 모든 tron 주소가 그래서 저장할 가치는 없다) 이걸 그냥 trasnaction 파싱을 할 때 넣어버리면 매번 비교할 때마다 많은 비용이 발생한다. bytearray로 다루게 되기 때문이다. 그래도 다행인점은 이러한 address space에 비해서 실제 존재하는 address는 훨씬 적기 때문에, int나 long으로 할당해주면 된다. postgres에서 serial등 이용하면 간편하다.
물론 그럼 집어 넣을때 마다 select를 해야해서 불편한거 아닌가, 그게 더 비용 아닌가, 이렇게 생각할 수도 있다. 맞다. 근데 어짜피 나중에 ml에 돌리려면 어짜피 이 node들을 숫자로 변환해야한다. clustering을 bytearray에 대고 할 수는 없으니까. OLAP를 만드는게 목적이라고 하면 결국 해야할 일이니까 미리 해두어도 좋다. 물론 그때는 n자체를 줄이기 위해서 또 다시 그것에 id는 여전히 할당해야하지만, int에서 int로 연산을 하는게 훨씬 빠르니 말이다. 이런 비지도 학습 프레임워크에서 실제로 이 주소가 무엇이었는지 궁금할때는 결국 사람이 직접 case study를 할때 밖에 없기 때문에, 최종 bytearray를 자주 볼 일 자체가 별로 없다는 것을 이용하는 것이기도 하다.
흠... 그래도 이런 글들은 그냥 내가 속으로 담아둔 이야기들을 의식의 흐름대로 풀어가기만 하면 되어서 나름 쓰기는 쉽다. 나중에 블로그를 보시는 다른 현업자 분들이 봤을 때 이런 것을 경험했구나 정도만 이해해주셔도 감사할 따름이다...


